- Published on
基于 LLM Worker 的自动化软件研发流水线架构设计
- Authors

- Name
- JiGu
- @crypto20x
引言:从“代码辅助”走向“自主研发集群”
随着大语言模型(LLM)与智能体(Agent)技术的快速演进,AI 在软件工程中的应用正在经历从 Copilot 单点代码补全 到 端到端自主研发流水线(Autonomous Software Engineering Pipeline) 的质变跃迁。
传统的 AI 编程助手依赖开发者在 IDE 中单向对话与逐行审查,虽然提升了微观编码效率,但在处理复杂模块、跨文件重构、自动化测试与团队协作等宏观研发流程时,依然存在明显的瓶颈:
- 缺乏全局规范约束,容易产生上下文幻觉;
- 依赖单点人工触发,无法弹性并发扩展;
- 缺乏严格的工程准入与测试闭环,交付质量不可控。
为了应对这些挑战,一种基于规范驱动(Spec-Driven)、中心化调度网关、并发弹性 Worker 池以及**人在回路(Human-in-the-Loop)**的现代化 AI 自动化软件研发流水线应运而生。
架构全景
下图完整呈现了一套企业级 AI 自动化研发流水线的系统拓扑与核心数据流:
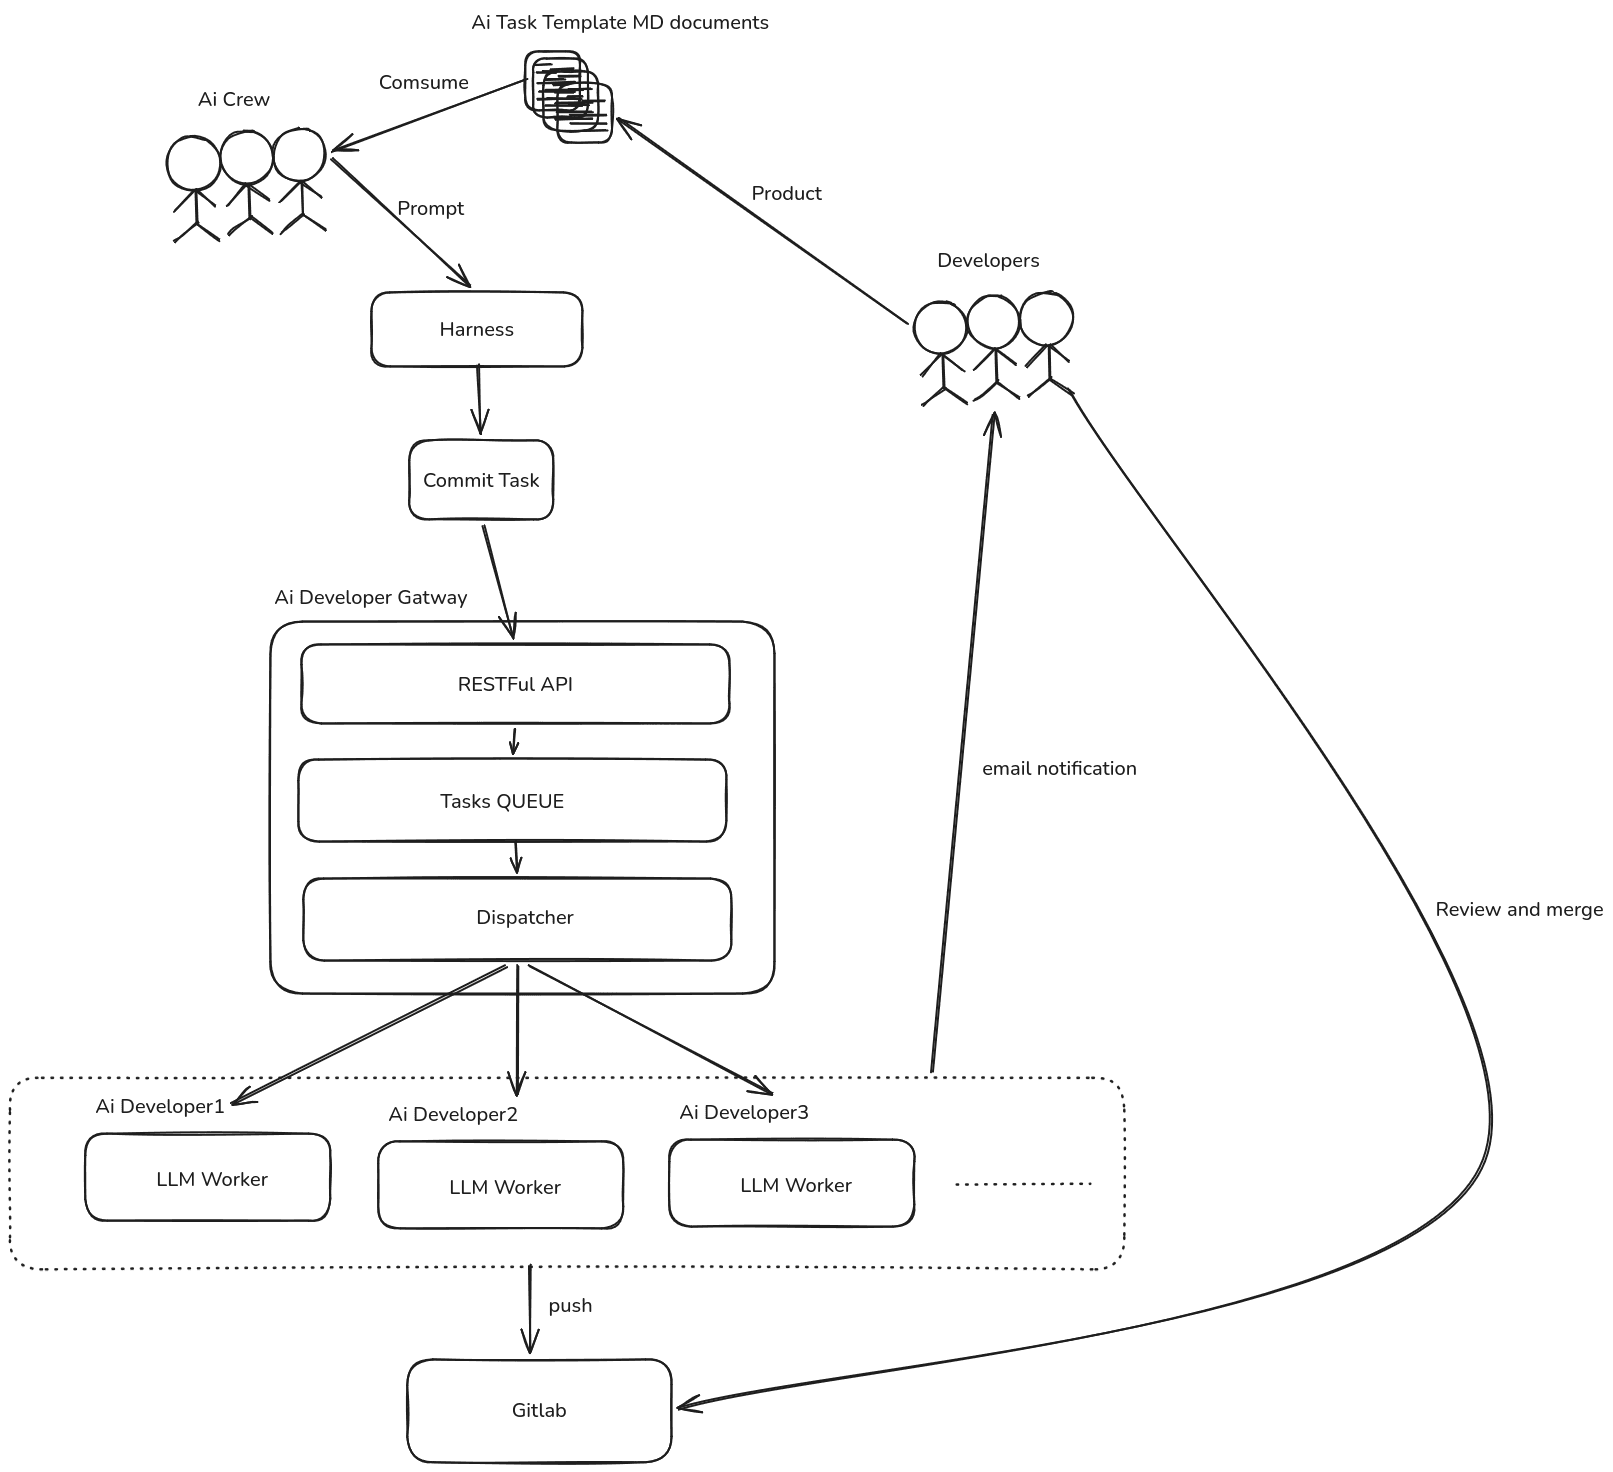
整个流水线形成了一个稳健的闭环:
- 人类开发者(Developers) 负责制定高标准的业务与技术规范(
Ai Task Template MD documents); - AI Crew 与 Harness 编排层 摄取规范文档并转化为带有执行约束的开发任务;
- AI 开发网关(Ai Developer Gateway) 通过 RESTful API 接入、任务队列缓冲与调度器分发;
- 并发 LLM Worker 集群 弹性拉起并执行编码、自测,将结果分支提交至版本控制中心;
- Gitlab 审查与邮件通知机制 将代码安全交付回人类手中,由人类工程师完成最终把关与合并。
核心组件与工程剖析
1. 规范驱动开发:Markdown 任务模板(Spec-Driven Development)
在流水线的起点,人类工程师的角色发生了关键跃迁——从“直接代码搬砖者”转变为“系统规范架构师(Spec Architect)”。
流水线拒绝非结构化、模棱两可的口头需求,而是要求人类开发者产出标准的 Markdown 需求模板(Ai Task Template MD documents)。一个优秀的 AI 任务模板通常包含:
- Context & Goal:目标仓库模块、业务背景与具体改造目标;
- Interface & Schema:明确的入参、出参类型与数据结构契约;
- Acceptance Criteria (AC):可验证的验收条件与必须通过的自动化用例;
- Non-Functional Requirements:依赖版本限制、性能指标与安全边界。
通过规范模板驱动(Spec-Driven),从源头极大地压缩了大模型的幻觉空间,确保了下游 Agent 动作的确定性。
2. 执行基座与约束控制:Ai Crew & Harness
单纯把文本丢给大模型是不够的,还需要一个承上启下的系统将“规范”具象为“可执行任务”:
- Ai Crew:扮演编排调度与元提示(Meta-Prompting)生成的角色,负责消费(
Consume)人类开发者产出的模板文档,注入当前仓库的代码图谱信息,构建精确的工程 Prompt; - Harness(测试基座与执行容器):Harness 的本质是一个“防脱轨底盘”。它负责配置沙箱环境、预置依赖、挂载断言工具,并将元任务打包封装为标准化的提交单元——
Commit Task。
Harness 确保了每一个任务在下发前,都具备了环境隔离性、执行幂等性与可验证性。
3. 中心化服务网关:Ai Developer Gateway
由于大语言模型在进行代码生成、静态分析与单元测试时是典型的长耗时、高计算负载任务(单次执行可能持续数分钟),系统通过网关层实现高度解耦:
- RESTful API:提供标准的 HTTP 接口,接收来自 Harness 或上游 CI/CD 触发器的任务提交,完成鉴权、格式校验与任务注册;
- Tasks QUEUE(任务缓冲队列):核心的削峰填谷中间件(如 Redis、RabbitMQ 或 Kafka)。无论上游任务以何种速率涌入,队列保证任务不丢失,支持按优先级排队、失败自动重试与死信兜底;
- Dispatcher(任务分发器):负责全局状态监控与智能路由。根据当前活跃 Worker 池的负载水位、GPU/Token 速率限制(Rate Limit)及各子任务类型,将排队任务动态下发给对应的 Worker 实例。
4. 弹性扩展的执行集群:LLM Worker Pool
系统的执行核心是由横向弹性伸缩的 LLM Worker(Ai Developer 1..N)组成的并发集群:
+-----------------------------------------------------------+
|                   LLM Worker 集群 (Worker Pool)           |
|                                                           |
|  +------------------+  +------------------+  +---------+  |
|  |  Ai Developer 1  |  |  Ai Developer 2  |  |   ...   |  |
|  |  (LLM Worker)    |  |  (LLM Worker)    |  | (弹性)  |  |
|  |  - 环境沙箱      |  |  - 环境沙箱      |  |         |  |
|  |  - 思考/编码循环 |  |  - 思考/编码循环 |  |         |  |
|  |  - 本地验证测试  |  |  - 本地验证测试  |  |         |  |
|  +------------------+  +------------------+  +---------+  |
+-----------------------------------------------------------+
- 无状态与轻量沙箱:每个 Worker 运行在独立的容器或无状态环境内,克隆对应代码库并检出隔离的特性分支(如
feat/ai-task-xxx); - 自主 ReAct 执行闭环:Worker 接收任务后,在本地执行“理解代码 -> 编写修改 -> 运行单元测试 -> 捕获报错 -> 自主修复”的循环,直至本地所有既定断言通过;
- 横向扩展能力:图中的省略号(
............)表明该 Worker 集群支持按需水平伸缩(Horizontal Scaling)。无论是处理单一模块还是批量刷几百个 API 的迁移任务,只需增加 Worker 容器数量即可实现近线性的吞吐提升。
5. 交付与人在回路:Gitlab & Human-in-the-Loop
为了保障生产环境代码资产的绝对安全与合规,架构坚持严格的 Human-in-the-Loop(人在回路) 原则:
- 分支交付(Push):Worker 严禁直接向受保护的
main/master分支推送,只能将代码push到其对应的独立特性分支,并自动创建 Merge Request (MR); - 异步事件通知(Email Notification):Worker 完成交付后,即刻向人类开发者发送邮件通知,附带 MR 链接、修改摘要、测试覆盖率报告与运行日志;
- 最终审查合入(Review and merge):人类工程师点击链接进入 Gitlab,针对差异进行人工审查(Code Review)。审查通过后手动点击 Merge,完成整个开发闭环;若有瑕疵,可直接打回并附带修改意见,触发新一轮的 Agent 修复迭代。
业务流转时序(Sequence Diagram)
整个流水线的完整时序流转如下:
sequenceDiagram
    autonumber
    actor Dev as Developers (人类开发者)
    participant Spec as Markdown 任务模板
    participant Crew as Ai Crew
    participant Harness as Harness 执行基座
    participant Gateway as Ai Developer Gateway
    participant Workers as LLM Worker (Worker Pool)
    participant Git as Gitlab

    Dev->>Spec: 编写任务规范文档 (Product)
    Crew->>Spec: 摄取规范内容 (Consume)
    Crew->>Harness: 组装 Prompt 与环境上下文
    Harness->>Gateway: 提交标准化任务 (Commit Task)

    rect rgb(240, 248, 255)
        note over Gateway: RESTful API 接收 -> Tasks QUEUE 缓冲排队
        Gateway->>Gateway: Dispatcher 负载调度
    end

    Gateway->>Workers: 下发任务给空闲 Worker

    rect rgb(245, 255, 245)
        note over Workers: 拉取代码 -> 编写实现 -> 本地自测与纠错
    end

    Workers->>Git: 推送特性分支与 MR (Push)
    Workers-->>Dev: 发送完成提醒 (Email Notification)

    Dev->>Git: 检查代码变更 (Review)
    Dev->>Git: 批准合并入库 (Merge)
落地实践的关键工程挑战与对策
在构建此类高并发、多智能体的软件研发流水线时,实际落地往往会遇到以下工程痛点,需提前做好架构治理:
1. 上下文膨胀与局部视野控制
- 痛点:大型代码库往往有数十万甚至百万行代码,无法全部塞入 Context 窗口。
- 对策:Worker 必须依赖高效的代码索引工具(如 AST 语法树解析、符号跳转服务、BM25/向量混合代码搜索),只把任务依赖的最精炼接口与文件片段喂给模型,避免上下文污染。
2. 沙箱安全与执行隔离
- 痛点:LLM Worker 在执行自测时需要运行终端命令(编译、跑测试),存在任意代码执行(RCE)与系统逃逸风险。
- 对策:每个 Worker 必须强制运行在轻量虚拟化环境(如 gVisor、Firecracker 或受限 Docker 容器)中,限制外部网络访问,防止敏感信息或凭证外泄。
3. 分支并发冲突与拆分粒度
- 痛点:多个 LLM Worker 并发修改相近文件时,极易产生 Git 分支冲突。
- 对策:上游人类编写的 Markdown 任务模板必须遵守低耦合、单一职责原则,按包或模块粒度拆分子任务,避免多 Worker 同时操作共享状态或同一文件。
4. Token 预算与模型分层策略
- 痛点:高强度的并发 Worker 如果全部调用超大旗舰模型,成本与延迟开销巨大。
- 对策:实行模型分级策略。例如由轻量且快速的模型负责环境探测、单测运行与简单格式修复,由高智能推理模型负责复杂核心算法的设计与编码。
总结
基于 LLM Worker 的自动化研发流水线并非取代人类程序员,而是将人类开发者从繁琐重复的样板代码、繁杂调试中解放出来,将核心精力聚焦在**架构决策、业务规范定义(Spec)与代码评审合入(Review & Merge)**上。
通过标准化的 Markdown 规范、解耦的网关队列、弹性的 Worker 集群以及受控的人在回路安全审计,这种架构为企业规模化引入 AI 智能体编码提供了清晰、安全且高度可落地的工程蓝图。